
はじめに
『Pythonで学ぶ空間データサイエンス入門』の独学時のまとめノートです。「定義編・導出編」「作図編・実装編」「可視化編」の三部構成でモデルやアルゴリズムの理解を目指します。
本の内容から寄り道・回り道しながら進めます。本を読んだ上で補助的に読んでください。
この記事では、LMIについて、図を使って解説します。
【前の内容】
【他の内容】
【今回の内容】
2.4 ローカル・モランのIの作図
空間的自己相関(spatial autocorrelation)の指標であるローカル・モランのI(LMI・local Moran's I)のグラフを作成します。
LMIについては「2.4:ローカル・モランのIの定義式【空間DS入門のノート】 - からっぽのしょこ」を参照してください。
利用するライブラリを読み込みます。
# ライブラリを読込
import geopandas as gpd
from pysal.lib import weights
import numpy as np
import matplotlib.pyplot as plt
import matplotlib.patches as mpatches # 凡例用
import japanize_matplotlib # 日本語の描画用
データの読込
まずは、地理空間データを読み込んで、前処理を行います。
詳しくは本の1.1節を参照してください。
国土数値情報ダウンロードサイトのデータの場合
この例では、国土数値情報ダウンロードサイトから2026年版(基準年)の大阪府の行政区域データ・地価公示データをダウンロードして、大阪市のデータを利用します。
「国土数値情報ダウンロードサイト」の行政区域データ・地価公示データを読み込みます。
# ファイルパスを指定
DISTRICT_PATH = 'data/N03-20260101_27_GML/N03-20260101_27.shp' # ポリゴンデータ:大阪府(2026年版)
LAND_PATH     = 'data/L01-26_27_GML/L01-26_27.shp'             # 地価公示:大阪府(2026年版)

# データを読込
gdf_district = gpd.read_file(DISTRICT_PATH, encoding='UTF-8') # (2026年版の場合)
gdf_land     = gpd.read_file(LAND_PATH, encoding='shift-jis') # (2026年版の場合)

# 行政区域データを取得
gdf_district         = gdf_district[['N03_004', 'N03_005', 'N03_007', 'geometry']] # (2026年版の場合)
gdf_district.columns = ['city1', 'city2', 'd_code', 'geometry']

# 地価公示データを取得
gdf_land         = gdf_land[['L01_024', 'L01_001', 'L01_008', 'geometry']] # (2026年版の場合)
gdf_land.columns = ['city', 'd_code', 'price', 'geometry']

# データを整形
dst_proj     = 6668
gdf_district = gdf_district.to_crs(epsg=dst_proj) # 空間座標系を再設定
gdf_land     = gdf_land.to_crs(epsg=dst_proj)     # 空間座標系を再設定

# データを加工
gdf_land['log_price'] = np.log(gdf_land['price']) # 対数地価公示価格
事前に保存しておいた行政区域のポリゴンデータと地価公示データを読み込みます。
必要に応じて扱いやすいようにデータを整形しておきます。
行政区域データをまとめます。
# データを統合
gdf_target = gdf_district.dissolve(by='d_code', as_index=False) # 飛び地を統合
gdf_target = gdf_target.merge(
    gdf_land.groupby('d_code')['log_price'].mean(),
    on='d_code'
) # 平均対数地価公示価格
gdf_target['centroids'] = gdf_target['geometry'].centroid # 重心座標

# データフレームを整形
gdf_target = gdf_target.reindex(
    columns=['city1', 'city2', 'd_code', 'log_price', 'geometry', 'centroids']
) # (目視での確認用)
市区町村(行政区域コード)ごとに、飛び地などのポリゴンデータをまとめて、重心座標を求めます。(この処理だと警告文が出ますが、ここでの目的には影響しない誤差なので無視します。)
また、市区町村ごとに対数地価公示価格の平均を計算して、データフレームに結合します。
大阪市のデータを取り出します。
# 地域を指定
city_name = '大阪市'

# データを抽出
gdf_target = gdf_target[gdf_target['city1'] == city_name]
gdf_target.head()
| city1 | city2 | d_code | log_price | geometry | centroids | |
|---|---|---|---|---|---|---|
| 0 | 大阪市 | 都島区 | 27102 | 13.013004 | POLYGON ((135.51481 34.72057, 135.51489 34.720... | POINT (135.52721 34.71193) |
| 1 | 大阪市 | 福島区 | 27103 | 13.507231 | POLYGON ((135.46247 34.6874, 135.46253 34.6879... | POINT (135.47534 34.6939) |
| 2 | 大阪市 | 此花区 | 27104 | 12.339599 | MULTIPOLYGON (((135.34359 34.62112, 135.34357 ... | POINT (135.42011 34.668) |
| 3 | 大阪市 | 西区 | 27106 | 14.140507 | POLYGON ((135.46667 34.67284, 135.4642 34.6747... | POINT (135.48375 34.67776) |
| 4 | 大阪市 | 港区 | 27107 | 12.555794 | MULTIPOLYGON (((135.43006 34.64979, 135.43006 ... | POINT (135.45084 34.66032) |
大阪府全域だとゴチャゴチャして分かりにくいので、大阪市内の区のデータを利用することにします。
以上で、LMIの計算や作図に利用する地理空間データを用意できました。
スポンサードリンク
統計量の計算
次は、ローカル・モランのIなどを計算する関数を作成して、データから統計量を計算します。
実装
空間ラグの計算を自作関数として定義します。
# SLの計算を実装
def calc_SL(x, W):

    # 偏差を計算
    x_dev = x - np.mean(x)

    # SLを計算
    SL = W @ x_dev
    return SL
空間ラグの計算については「【Python】2.3:空間ラグの実装【空間DS入門のノート】 - からっぽのしょこ」を参照してください。
LMIの計算を自作関数として定義します。
# LMIの計算を実装
def calc_LMI(x, W, ddof=0):

    # 偏差を計算
    x_dev = x - np.mean(x)

    # 標本分散を計算
    x_var = np.var(x, ddof=ddof)

    # SLを計算
    SL = W @ x_dev

    # LMIを計算
    LMI  = x_dev / x_var * SL
    return LMI
LMIの計算については「【Python】2.4:ローカル・モランのIの実装【空間DS入門のノート】 - からっぽのしょこ」を参照してください。
LMIの優位性検定におけるp値の計算を自作関数として定義します。
# LMIの優位性検定を実装
def local_moran_test(x, W, iteration=999, alternative='two-sided'):

    # 形状を調整
    x = x.flatten()

    # 地域数を設定
    N = len(x)

    # 標本統計量を計算
    x_dev = x - np.mean(x)    # 偏差
    x_var = np.var(x, ddof=0) # 標本分散

    # LMIを計算:(観測値)
    LMI_obs = calc_LMI(x, W, ddof=0)

    # 乱数生成器を作成
    rng = np.random.default_rng()

    # 受け皿を初期化
    cnts = np.zeros(N, dtype=np.int16)

    # 地域ごとに検定
    for i in range(N):

        # カウントを初期化
        extreme_cnt = 0

        # 置換検定
        for _ in range(iteration):

            # データを置換
            d_perm       = x_dev.copy() # 偏差を複製
            mask         = np.arange(N) != i # 置換対象のインデックス
            d_perm[mask] = rng.permutation(d_perm[mask]) # 偏差を並べ替え

            # LMIを計算:(置換値)
            SL_perm_i  = np.sum(W[i] * d_perm)
            LMI_perm_i = x_dev[i] / x_var * SL_perm_i

            # 置換値と観測値を比較
            if alternative == 'two-sided': # 両側検定:(HH, HL, LH, LL)
                is_extreme = np.abs(LMI_perm_i) >= np.abs(LMI_obs[i])
            elif alternative == 'greater': # 右側検定:(HH, LL)
                is_extreme = LMI_perm_i >= LMI_obs[i]
            elif alternative == 'less':    # 左側検定:(HL, LH)
                is_extreme = LMI_perm_i <= LMI_obs[i]

            # 棄却域に入る値をカウント
            if is_extreme:
                extreme_cnt += 1

        # 結果を記録
        cnts[i] = extreme_cnt

    # p値を計算
    p = (cnts + 1) / (iteration + 1)
    return p
優位性検定やp値の計算については「【Python】2.4:ローカル・モランのIの優位性検定の実装【空間DS入門のノート】 - からっぽのしょこ」を参照してください。
計算
入力データを設定します。
# データを取得
x = gdf_target['log_price'].to_numpy()
print(x[:5].round(2))
print(x.shape)
[13.01 13.51 12.34 14.14 12.56]
(24,)
個の地域のデータ
を作成します。
この例では、平均対数地価公示価格を使います。
空間重み行列を作成します。
# 空間重み行列を作成
adj_obj = weights.Rook.from_dataframe(
    df=gdf_target, geom_col='geometry', use_index=False
)
adj_obj.transform = 'R' # 正規化
W, _ = adj_obj.full()
print(W[:5, :5].round(2))
print(W.shape)
[[0.   0.   0.   0.   0.  ]
 [0.   0.   0.2  0.2  0.  ]
 [0.   0.25 0.   0.25 0.25]
 [0.   0.14 0.14 0.   0.14]
 [0.   0.   0.33 0.33 0.  ]]
(24, 24)
空間重み行列 を作成します。
この例では、ルーク型の空間隣接行列を用いて、空間重み行列を作成しています。
空間重み行列については「【Python】2.2:空間重み行列の作図:境界の共有【空間データサイエンス入門のノート】 - からっぽのしょこ」を参照してください。
LMIを計算をします。
# LMIを計算
LMI = calc_LMI(x, W)
print(LMI[:5].round(2))
print(LMI.shape)
[ 0.13  0.36 -0.2   1.05  0.01]
(24,)
自作関数を使って、 個の地域のLMI
を計算します。
LMIの優位性検定におけるp値を計算します。
# p値を計算
p = local_moran_test(x, W)
print(p[:5].round(3))
print(p.shape)
[0.056 0.318 0.574 0.045 0.987]
(24,)
自作関数を使って、 個の地域のLMIのp値
を計算します。
以上で、作図に利用する統計量を求まりました。
スポンサードリンク
グラフの作成
続いて、ローカル・モランのIの図を作成します。
データの確認
データをコロプレス図で確認します。
作図コード(クリックで展開)
# 地域数を取得
N = len(gdf_target)

# 値を格納
gdf_target['deviation']   = x_dev = x - np.mean(x) # 偏差
gdf_target['spatial_lag'] = calc_SL(x, W) # 空間ラグ
# 配色の範囲を設定
u = 0.5
x_min = gdf_target['log_price'].min()
x_max = gdf_target['log_price'].max()
x_min = np.floor(x_min /u)*u # u単位で切り下げ
x_max = np.ceil(x_max /u)*u  # u単位で切り上げ
u = 0.1
d_size = gdf_target['deviation'].abs().max()
d_size = np.ceil(d_size /u)*u  # u単位で切り上げ
u = 0.1
sl_size = gdf_target['spatial_lag'].abs().max()
sl_size = np.ceil(sl_size /u)*u  # u単位で切り上げ

# データを作図
fig, axes = plt.subplots(
    nrows=2, ncols=2,
    figsize=(18, 12), dpi=100, facecolor='white',
    constrained_layout=True
)
fig.suptitle('choropleth map', fontsize=20)

## 入力データの作図

# ラベルを作成
fml_lbl = '$x_i$'

# 入力データを描画
ax = axes[0, 0]
gdf_target.boundary.plot(
    ax=ax,
    edgecolor='white', linewidth=0.5
) # 行政区界
gdf_target.plot(
    ax=ax, column='log_price',
    cmap='viridis', vmin=x_min, vmax=x_max,
    legend=True, legend_kwds={'label': fml_lbl, 'shrink': 0.9}
) # 入力データ
for n in range(N):
    area_x, area_y = gdf_target.loc[n, 'centroids'].coords[0] # 座標
    area_lbl       = gdf_target.loc[n, 'city2'] # 地域名
    ax.text(
        x=area_x, y=area_y, s=area_lbl, ha='center', va='center',
        size=10
    ) # 地域名
ax.set_xlabel('longitude')
ax.set_ylabel('latitude')
ax.set_title('input data', fontsize=20)
ax.grid()
ax.set_aspect(aspect='equal', adjustable='box')

## 偏差の作図

# ラベルを作成
fml_lbl = '$x_i - \\bar{x}$'

# 偏差を描画
ax = axes[0, 1]
gdf_target.boundary.plot(
    ax=ax,
    edgecolor='white', linewidth=0.5
) # 行政区界
gdf_target.plot(
    ax=ax, column='deviation',
    cmap='coolwarm', vmin=-d_size, vmax=d_size,
    legend=True, legend_kwds={'label': fml_lbl, 'shrink': 0.9}
) # 偏差
for n in range(N):
    area_x, area_y = gdf_target.loc[n, 'centroids'].coords[0] # 座標
    area_lbl       = gdf_target.loc[n, 'city2'] # 地域名
    ax.text(
        x=area_x, y=area_y, s=area_lbl, ha='center', va='center',
        size=10
    ) # 地域名
ax.set_xlabel('longitude')
ax.set_ylabel('latitude')
ax.set_title('deviation', fontsize=20)
ax.grid()
ax.set_aspect(aspect='equal', adjustable='box')

## SLの作図

# ラベルを作成
fml_lbl = '$SL_i = \\sum_{i=1}^N w_{ij} (x_j - \\bar{x})$'

# SLを描画
ax = axes[1, 1]
gdf_target.boundary.plot(
    ax=ax,
    edgecolor='white', linewidth=0.5
) # 行政区界
gdf_target.plot(
    ax=ax, column='spatial_lag',
    cmap='coolwarm', vmin=-sl_size, vmax=sl_size,
    legend=True, legend_kwds={'label': fml_lbl, 'shrink': 0.9}
) # 空間ラグ
for n in range(N):
    area_x, area_y = gdf_target.loc[n, 'centroids'].coords[0] # 座標
    area_lbl       = gdf_target.loc[n, 'city2'] # 地域名
    ax.text(
        x=area_x, y=area_y, s=area_lbl, ha='center', va='center',
        size=10
    ) # 地域名
ax.set_xlabel('longitude')
ax.set_ylabel('latitude')
ax.set_title('spatial lag', fontsize=20)
ax.grid()
ax.set_aspect(aspect='equal', adjustable='box')

# 不要なサブプロットを非表示
axes[1, 0].axis('off')

plt.show()
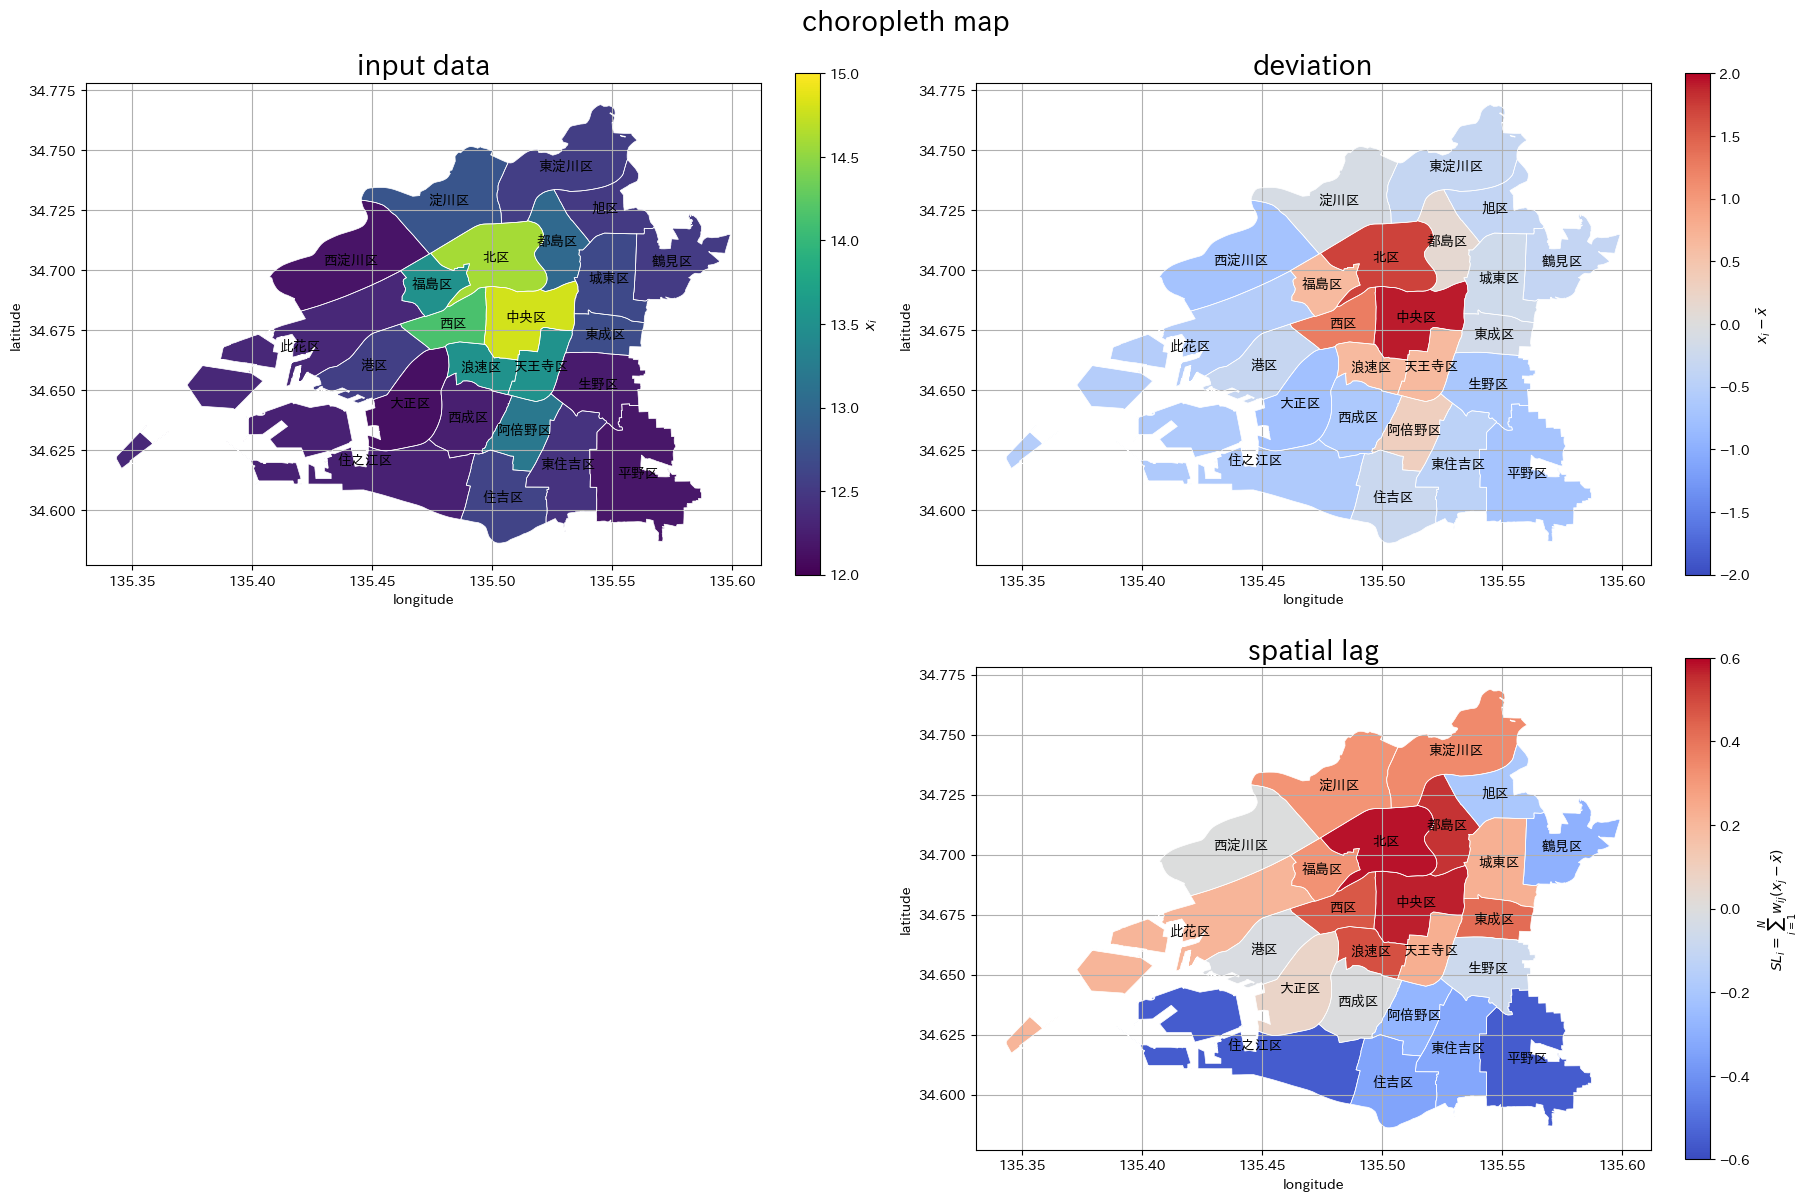
左上図はデータの値(平均対数地価公示価格)、右上図は偏差の値、右下図はSLの値をグラデーションで示します。偏差とSLの図に関しては、0を中心とする範囲でグラデーション(値が0のとき灰色、値が小さいほど濃い青色、値が大きいほど濃い赤色)を設定しています。
コロプレス図
LMIのコロプレス図を作成します。
# 地域数を取得
N = len(gdf_target)

# 値を格納
gdf_target['LMI'] = LMI # LMI
# 配色を設定
u = 0.1
v_size = gdf_target['LMI'].abs().max()
v_size = np.ceil(v_size /u)*u # u単位で切り上げ

# ラベルを作成
param_lbl = f'$N = {N}$'

# LMIを作図
fig, ax = plt.subplots(
    figsize=(9, 6), dpi=100, facecolor='white',
    constrained_layout=True
)
fig.suptitle('choropleth map', fontsize=20)

gdf_target.boundary.plot(
    ax=ax,
    edgecolor='white', linewidth=0.5
) # 行政区界
gdf_target.plot(
    ax=ax, column='LMI',
    cmap='coolwarm', vmin=-v_size, vmax=v_size,
    legend=True, legend_kwds={'label': 'LMI', 'shrink': 1.0}
) # LMI
for n in range(N):
    area_x, area_y = gdf_target.loc[n, 'centroids'].coords[0] # 座標
    area_lbl       = gdf_target.loc[n, 'city2'] # 地域名
    ax.text(
        x=area_x, y=area_y, s=area_lbl, ha='center', va='center',
        size=10
    ) # 地域名
ax.set_xlabel('longitude')
ax.set_ylabel('latitude')
ax.set_title(param_lbl, loc='left')
ax.grid()
ax.set_aspect(aspect='equal', adjustable='box')

plt.show()
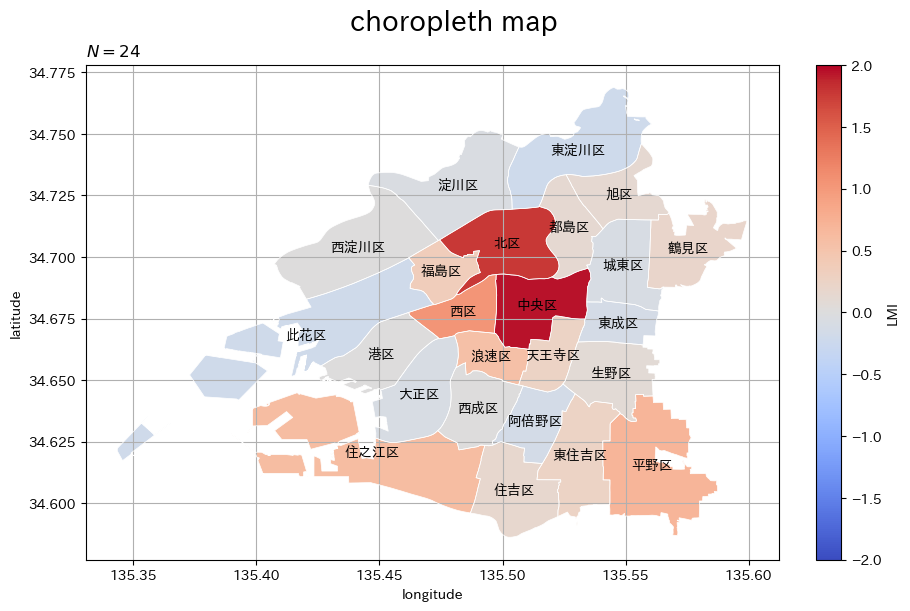
各地域のLMIを中心が0のグラデーションで示します。
GeoDataFrameと gdf.plot() を使って、コロプレス図(ポリゴン図・面図)を描画します。データ列の引数 column にLMIの列を指定します。
地域ごとのLMIを確認できます。
有意水準を指定して、データに優位性を反映します。
# 有意水準を指定
alpha = 0.05

# 優位性を反映
mask = p > alpha # 非有意のインデックス
gdf_target.loc[mask, 'LMI'] = np.nan # 非有意を置換
#gdf_target['LMI'] = np.where(p <= alpha, LMI, np.nan) # 非有意を置換

# データを確認
gdf_target['p_value'] = p # p値
gdf_target[['city2', 'p_value', 'LMI']].head()
| city2 | p_value | LMI | |
|---|---|---|---|
| 0 | 都島区 | 0.056 | NaN |
| 1 | 福島区 | 0.318 | NaN |
| 2 | 此花区 | 0.574 | NaN |
| 3 | 西区 | 0.045 | 1.046004 |
| 4 | 港区 | 0.987 | NaN |
有意水準 を指定します。
p値 が有意水準
より大きい(非有意
)地域のLMIを欠損値に置き換えます。
有意性をは反映したLMIのコロプレス図を作成します。
# 配色を設定
u = 0.1
v_size = gdf_target['LMI'].abs().max()
v_size = np.ceil(v_size /u)*u # u単位で切り上げ

# ラベルを作成
param_lbl = f'$N = {N}$'

# LMIを作図
fig, ax = plt.subplots(
    figsize=(9, 6), dpi=100, facecolor='white',
    constrained_layout=True
)
fig.suptitle('choropleth map', fontsize=20)

gdf_target.boundary.plot(
    ax=ax,
    edgecolor='black', linewidth=0.5
) # 行政区界
gdf_target.plot(
    ax=ax, column='LMI',
    cmap='coolwarm', vmin=-v_size, vmax=v_size,
    missing_kwds={'color': 'lightgrey'},
    legend=True, legend_kwds={'label': 'LMI', 'shrink': 1.0}
) # LMI
for n in range(N):
    area_x, area_y = gdf_target.loc[n, 'centroids'].coords[0] # 座標
    area_lbl       = gdf_target.loc[n, 'city2'] # 地域名
    ax.text(
        x=area_x, y=area_y, s=area_lbl, ha='center', va='center',
        size=10
    ) # 地域名
ax.set_xlabel('longitude')
ax.set_ylabel('latitude')
ax.set_title(param_lbl, loc='left')
ax.grid()
ax.set_aspect(aspect='equal', adjustable='box')

# 凡例を設定
handles = [
    mpatches.Patch(facecolor='lightgrey', label='Not significant')
]
ax.legend(
    handles=handles, loc='upper left'
) # 優位性

plt.show()
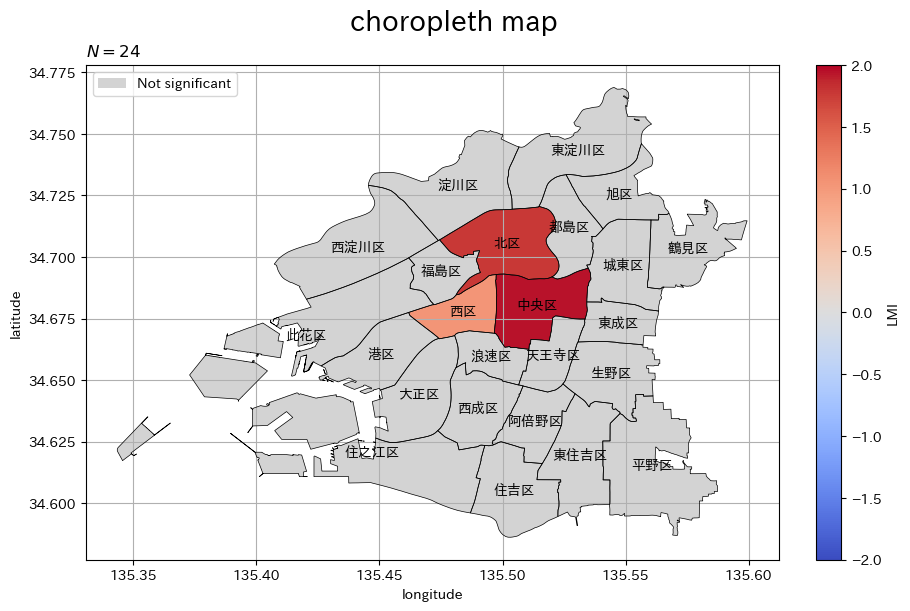
LMIが有意な地域をグラデーション、非有意な地域を灰色で示します。
欠損データに関する設定は、missing_kwds 引数に辞書型のオブジェクトで指定できます。引数名をキーとして値を指定します。
有意な地域のLMIを確認できます。
以上で、ローカル・モランのIの図を作成できました。
有意な地域のモラン散布図におけるカテゴリについては「【Python】2.4:LISAクラスターマップの作成【空間DS入門のノート】 - からっぽのしょこ」を参照してください。
この記事では、ローカル・モランのIを図で確認しました。次の記事では、優位性検定をプログラムで確認します。
参考文献

おわりに
LMIの図として色々考えたのですが、置換分布の図もLISAクラスターマップも別記事で扱うことにして、ここでは優位性を反映したコロプレス図に留めることにしました。いえ決して面倒になったわけでは…
しかし記事のリンクが増えて前後して入り組んでめんどうk…
最後に、たった今公開されたJuice=Juiceのライブ映像をどうぞ♪
夏ですねぇ、フェスですね。皆さんはいかがお過ごしでしょうか、私は家でフェスの放送や配信を観てブログを書いています。
【次の内容】
LMIの優位性検定をプログラムで確認します。
