
はじめに
『Pythonによるはじめての地理空間データサイエンス』の独学時のまとめノートです。「定義編・導出編」「実装編・作図編」「可視化編」の三部構成でモデルやアルゴリズムの理解を目指します。
本の内容から寄り道・回り道しながら進めます。本を読んだ上で補助的に読んでください。
この記事では、k-means法によるクラスタリングについて、Pythonを使ってスクラッチ実装する方法を解説します。
【前の内容】
【他の内容】
【今回の内容】
2.3 空間ラグのk-means法(クラスタリング)の実装
空間ラグ(SL・spatial lag)に対するk平均法(k-means algorithm)によるクラスタリング(clustering)を実装します。
SLについては「2.3:空間ラグの定義式【空間DS入門のノート】 - からっぽのしょこ」、より詳細なk-means法については「【Python】4.3:k平均法による多次元混合ガウス分布のクラスタリングの実装【『スタンフォード線形代数入門』のノート】 - からっぽのしょこ」を参照してください。
利用するライブラリを読み込みます。
# ライブラリを読込
import geopandas as gpd
from pysal.lib import weights
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.colors import ListedColormap # 配色用
import matplotlib.patches as mpatches # 凡例用
from pandas.api.types import CategoricalDtype # 配色用
import japanize_matplotlib # 日本語の描画用
データの読込
まずは、地理空間データを読み込んで、前処理を行います。
詳しくは本の2.2節を参照してください。
国土数値情報ダウンロードサイトのデータの場合
この例では、国土数値情報ダウンロードサイトから2026年版(基準年)の大阪府の行政区域データ・地価公示データをダウンロードして、データを利用します。
「国土数値情報ダウンロードサイト」の行政区域データ・地価公示データを読み込みます。
# ファイルパスを指定
DISTRICT_PATH = 'data/N03-20260101_27_GML/N03-20260101_27.shp' # ポリゴンデータ:大阪府(2026年版)
STATS_PATH    = 'data/L01-26_27_GML/L01-26_27.shp'             # 地価公示:大阪府(2026年版)

# データを読込
gdf_district = gpd.read_file(DISTRICT_PATH, encoding='UTF-8') # (2026年版の場合)
gdf_stats    = gpd.read_file(STATS_PATH, encoding='shift-jis') # (2026年版の場合)

# 行政区域データを取得
gdf_district         = gdf_district[['N03_004', 'N03_005', 'N03_007', 'geometry']] # (2026年版の場合)
gdf_district.columns = ['city1', 'city2', 'd_code', 'geometry']

# 地価公示データを取得
gdf_stats         = gdf_stats[['L01_024', 'L01_001', 'L01_008', 'geometry']] # (2026年版の場合)
gdf_stats.columns = ['city', 'd_code', 'price', 'geometry']

# データを整形
dst_proj     = 6668
gdf_district = gdf_district.to_crs(epsg=dst_proj) # 空間座標系を再設定
gdf_stats    = gdf_stats.to_crs(epsg=dst_proj)     # 空間座標系を再設定

# データを加工
gdf_stats['log_price'] = np.log(gdf_stats['price']) # 対数地価公示価格
事前に保存しておいた行政区域のポリゴンデータと地価公示データを読み込みます。
必要に応じて扱いやすいようにデータを整形しておきます。
行政区域データをまとめます。
# データを統合
gdf_target = gdf_district.dissolve(by='d_code', as_index=False) # 飛び地を統合
gdf_target = gdf_target.merge(
    gdf_stats.groupby('d_code')['log_price'].mean(),
    on='d_code'
) # 平均対数地価公示価格
gdf_target['centroids'] = gdf_target['geometry'].centroid # 重心座標

# データを整形
#gdf_target['city'] = gdf_target['city1'].fillna('') + gdf_target['city2'].fillna('') # 地域名を補完:政令指定都市名を残す場合
gdf_target['city'] = gdf_target['city2'].fillna(gdf_target['city1']) # 地域名を補完:政令指定都市名を除く場合

# データフレームを整形
gdf_target = gdf_target.reindex(
    columns=['city', 'city1', 'city2', 'd_code', 'log_price', 'geometry', 'centroids']
) # (目視での確認用)

# データを確認
gdf_target.head()
| city | city1 | city2 | d_code | log_price | geometry | centroids | |
|---|---|---|---|---|---|---|---|
| 0 | 都島区 | 大阪市 | 都島区 | 27102 | 13.013004 | POLYGON ((135.51481 34.72057, 135.51489 34.720... | POINT (135.52721 34.71193) |
| 1 | 福島区 | 大阪市 | 福島区 | 27103 | 13.507231 | POLYGON ((135.46247 34.6874, 135.46253 34.6879... | POINT (135.47534 34.6939) |
| 2 | 此花区 | 大阪市 | 此花区 | 27104 | 12.339599 | MULTIPOLYGON (((135.34359 34.62112, 135.34357 ... | POINT (135.42011 34.668) |
| 3 | 西区 | 大阪市 | 西区 | 27106 | 14.140507 | POLYGON ((135.46667 34.67284, 135.4642 34.6747... | POINT (135.48375 34.67776) |
| 4 | 港区 | 大阪市 | 港区 | 27107 | 12.555794 | MULTIPOLYGON (((135.43006 34.64979, 135.43006 ... | POINT (135.45084 34.66032) |
市区町村(行政区域コード)ごとに、飛び地などのポリゴンデータをまとめて、重心座標を求めます。(この処理だと警告文が出ますが、ここでの目的には影響しない誤差なので無視します。)
また、市区町村ごとに対数地価公示価格の平均を計算して、データフレームに結合します。
以上で、空間ラグの計算や作図に利用する地理空間データを用意できました。
統計量の計算
次は、空間ラグを計算する関数を作成して、データから統計量を計算します。
実装
SLの計算を自作関数として定義します。
# SLの計算を実装
def calc_SL(x, W):

    # 偏差を計算
    x_dev = x - np.mean(x)

    # SLを計算
    SL = W @ x_dev
    return SL
SLの計算については「【Python】2.3:空間ラグの実装【空間DS入門のノート】 - からっぽのしょこ」を参照してください。
計算
入力データを設定します。
# 入力データを取得
x = gdf_target['log_price'].to_numpy()
print(x[:5].round(2))
print(x.shape)
[13.01 13.51 12.34 14.14 12.56]
(72,)
個の地域の入力データ
を作成します。
この例では、平均対数地価公示価格を使います。
空間重み行列を作成します。
# 空間重み行列を作成
adj_obj = weights.Queen.from_dataframe(
    df=gdf_target, geom_col='geometry', use_index=False
)
adj_obj.transform = 'R' # 正規化
W, _ = adj_obj.full()
print(W[:5, :5].round(2))
print(W.shape)
[[0.   0.   0.   0.   0.  ]
 [0.   0.   0.2  0.2  0.  ]
 [0.   0.25 0.   0.25 0.25]
 [0.   0.14 0.14 0.   0.14]
 [0.   0.   0.33 0.33 0.  ]]
(72, 72)
空間重み行列 を作成します。
この例では、クイーン型の空間隣接行列を用いて、空間重み行列を作成しています。
空間重み行列については「【Python】2.2:空間重み行列の作図:境界の共有【空間DS入門のノート】 - からっぽのしょこ」を参照してください。
SLを計算をします。
# SLを計算
SL = calc_SL(x, W)
print(SL[:5].round(2))
print(SL.shape)
[1.49 1.27 1.15 1.41 0.93]
(72,)
自作関数を使って、 個の地域のSL
を計算します。
以上で、作図に利用する統計量を求まりました。
クラスタリングの処理
続いて、空間ラグに対するk-means法の処理の処理を確認します。
クラスタリングを行う変数をまとめます。
# 変数を結合
X = np.stack([x, SL], axis=1)
print(X[:5].round(2))
print(X.shape)
[[13.01  1.49]
 [13.51  1.27]
 [12.34  1.15]
 [14.14  1.41]
 [12.56  0.93]]
(72, 2)
地域 の入力データ
と空間ラグ
を2次元変数
として、まとめて扱います。また、
個の地域をまとめて
とします。
クラスタの代表値を初期化します。
# クラスタ数の初期値を指定
K = 4

# クラスタの代表値をランダムに設定
Z = np.stack(
    [np.random.uniform(low=X[:, 0].min(), high=X[:, 0].max(), size=K),
     np.random.uniform(low=X[:, 1].min(), high=X[:, 1].max(), size=K)],
    axis=1
) # 一様乱数
print(Z[:5].round(2))
print(Z.shape)
[[10.03 -1.65]
 [10.75 -1.44]
 [14.73  0.36]
 [13.85 -0.62]]
(4, 2)
クラスタ数 を指定します。
クラスタ の代表値を
、
個のクラスタをまとめて
として、ランダムに初期値を設定します。
この例では、変数 の範囲の一様乱数を使います。
連続型の一様分布の乱数は、np.random.uniform() で生成できます。確率変数の範囲の引数 low, high に各次元(軸)の変数の最小値・最大値、サンプルサイズの引数 size にクラスタ数を指定します。
クラスタ番号を割り当てます。
# クラスタを割当
c = np.argmin(
    [np.sqrt(np.sum((X - Z[k])**2, axis=1)) for k in range(K)],
    axis=0
) # 最小ノルムのインデックス
print(c[:5])
print(c.shape)
[2 2 3 2 3]
(72,)
各地域の変数 の点と各クラスタの代表値
の点の距離(ユークリッドノルム)を計算します。
2点の差ベクトルのノルムが最小となるクラスタ番号(変数からの距離が一番近い代表値の行インデックス)を、各地域のクラスタ とします。
個の地域(変数)のクラスタをまとめて
とします。
N 個の変数 X に対して、1つのクラスタの代表値 Z[k] との差をとり、ユークリッドノルム(2乗和の平方根)を計算します。N 個のノルムを1列として、K 回( K 列分)計算して、(N, K) の2次元配列に格納します。
行ごとに最大値のインデックス(列番号)を np.argmax() で取り出します。
または、ユークリッドノルムを np.linalg.norm() で計算します。
# クラスタを割当
c = np.argmin(
    [np.linalg.norm(X - Z[k], axis=1) for k in range(K)], # ノルム
    axis=0
) # 最小ノルムのインデックス
print(c[:5])
print(c.shape)
[2 2 3 2 3]
(72,)
目的関数を計算します。
# 目的関数を計算
J = np.mean(
    np.sum((X - Z[c])**2, axis=1) # ノルムの2乗
) # ノルムの2乗平均
print(J)
2.507108731706555
目的関数として、ノルムの2乗平均を計算します。
N 個の変数 X に対して、各変数に割り当てられたクラスタの代表値 Z[c] との差をとり、ユークリッドノルムの2乗(2乗和)を計算します。N 個のノルムの平均を計算します。
または、ノルムの計算のための和( D 個の和)の計算と、平均の計算のための和( N 個の和)の計算を、1つの np.sum() でまとめて処理します。
# データ数を取得
N = len(gdf_target)

# 目的関数を計算
J = np.sum((X - Z[c])**2) / N # ノルムの2乗平均
print(J)
2.5071087317065546
ユークリッドノルムの2乗は、2乗和の平方根の2乗であり、2乗和と同じなので、計算を省略しています。
k-means法によりクラスタリングします。
# 目的関数の更新量の閾値を指定
threshold = 0.001

# 最大試行回数を指定
max_iter = 100

# カウントを初期化
iter_cnt = 0

# 初期値を記録
old_J = J

# k-meansによるクラスタリング
while iter_cnt < max_iter: # 無限ループの回避用

    # 試行回数をカウント
    iter_cnt += 1
    print(f'----- iteration: {iter_cnt} -----')
    print(f'K   = {K}')

    # クラスタの代表値を計算
    Z = np.array(
        [np.mean(X[c == k], axis=0) for k in range(K)]
    ) # 平均

    # クラスタを割当
    c = np.argmin(
        [np.linalg.norm(X - Z[k], axis=1) for k in range(K)], # ノルム
        axis=0
    ) # 最小ノルムのインデックス

    # クラスタの割当数を集計
    clust_num = np.array(
        [np.sum(c == k) for k in range(K)]
    ) # 度数
    print(f'|G| = {clust_num}')

    # 目的関数を計算
    J = np.mean(
        np.sum((X - Z[c])**2, axis=1) # ノルムの2乗
    ) # ノルムの2乗平均
    #J = np.sum((X - Z[c])**2) / N # ノルムの2乗平均
    print(f'J   = {J:.5f}')

    # 試行終了を判定
    delta_J = abs(J - old_J) # 更新量
    if delta_J < threshold: # 変化がない場合
        break

    # 更新値を記録
    old_J = J
----- iteration: 1 -----
K   = 4
|G| = [ 7 28  7 30]
J   = 0.27357
----- iteration: 2 -----
K   = 4
|G| = [ 8 27  7 30]
J   = 0.26229
----- iteration: 3 -----
K   = 4
|G| = [10 26  7 29]
J   = 0.25975
----- iteration: 4 -----
K   = 4
|G| = [11 25  7 29]
J   = 0.25207
----- iteration: 5 -----
K   = 4
|G| = [11 25  7 29]
J   = 0.25075
----- iteration: 6 -----
K   = 4
|G| = [11 25  7 29]
J   = 0.25075
個のクラスタの代表値
の更新、
個の変数のクラスタ
の更新、目的関数
の更新を収束するまで繰り返します。
N 個の変数 X から各クラスタ k が割り当てられた変数 X[c == k] を取り出して、次元(軸)ごとに平均値を計算して、代表値の更新値とします。
閾値 threshold を指定して、目的関数(ノルムの2乗平均) J の変化量(1試行前の目的関数 old_J との差)が閾値未満になるまで、クラスタの更新を繰り返します。
目的関数の変化量 delta_J が閾値未満になる(目的関数の変化が微小になる)と、while ループを break で終了します。
または、最大試行回数 max_iter を指定して、指定した回数まで更新を繰り返します。無限ループの対策としても機能します。
試行回数 iter_cnt が最大試行回数に達すると、while ループを終了します。
以上の処理を実装します。
クラスタリングの実装
k-means法の処理を行う関数を作成します。
実装
k-means法を自作関数として定義します。
# k-means法を実装
def k_means_method(X, K=5, threshold=0.001, max_iter=100):

    # データ数・次元数を取得
    N, D = X.shape

    # カウントを初期化
    iter_cnt = 0

    # k-meansによるクラスタリング
    while iter_cnt < max_iter: # 無限ループの回避用

        # クラスタの代表値を計算
        if iter_cnt > 0: # 初回を除く
            Z = np.array(
                [np.mean(X[c == k], axis=0) for k in range(K)]
            ) # 平均
        else: # 初回の場合
            Z = np.stack(
                [np.random.uniform(low=X[:, d].min(), high=X[:, d].max(), size=K) for d in range(D)],
                axis=1
            ) # 一様乱数

        # クラスタを割当
        c = np.argmin(
            [np.linalg.norm(X - Z[k], axis=1) for k in range(K)], # ノルム
            axis=0
        ) # 最小ノルムのインデックス

        # 目的関数を計算
        J = np.mean(
            np.sum((X - Z[c])**2, axis=1) # ノルムの2乗
        ) # ノルムの2乗平均

        # 試行終了を判定
        if iter_cnt > 0: # 初回を除く
            delta_J = abs(J - old_J) # 更新量
            if delta_J < threshold: # 変化がない場合
                break

        # 更新値を記録
        old_J = J

        # 試行回数をカウント
        iter_cnt += 1

    # クラスタ番号を出力
    return c
「クラスタリング」の処理を関数として実装します。ただし、初期化の処理を初回のループに組み込んでいます。
クラスタ数を K 引数、閾値を threshold 引数、最大試行回数を max_iter 引数に指定します。
ランダムな処理を含むので、データやパラメータが同じでも実行する度に結果が変わることがあります。
変数やクラスタの初期値によっては、どの地域(変数)にも割り当てられないクラスタが生じることがあります。
クラスタ数の更新などの機能については「【Python】4.3:k平均法による多次元混合ガウス分布のクラスタリングの実装【『スタンフォード線形代数入門』のノート】 - からっぽのしょこ」を参照してください。
クラスタリング
空間ラグをk-means法によりクラスタリングします。
# クラスタ数を指定
K = 4

# クラスタを割当
c = k_means_method(X, K=K)
print(c[:5])
print(c.shape)

# クラスタの割当数を集計
clust_num = np.array(
    [np.sum(c == k) for k in range(K)]
) # 度数
print(clust_num)
print(clust_num.shape)
[2 0 2 0 2]
(72,)
[ 6 30 22 14]
(4,)
自作関数を使って、各データのクラスタ番号 を作成します。
以上で、k-means法によるクラスタリングを実装できました。
グラフの作成
最後は、クラスタの図を作成します。
データの確認
データをコロプレス図で確認します。
作図コード(クリックで展開)
# データ数を取得
N = len(gdf_target)

# 値を格納
gdf_target['spatial_lag'] = SL
# 配色の範囲を設定
u = 1.0
x_min = gdf_target['log_price'].min()
x_max = gdf_target['log_price'].max()
x_min = np.floor(x_min /u)*u # u単位で切り下げ
x_max = np.ceil(x_max /u)*u  # u単位で切り上げ
u = 0.5
v_size = gdf_target['spatial_lag'].abs().max()
v_size = np.ceil(v_size /u)*u  # u単位で切り上げ

# ラベルを作成
param_lbl = f'$N = {N}$'

# データを作図
fig, axes = plt.subplots(
    nrows=1, ncols=2,
    figsize=(16, 9), dpi=100, facecolor='white',
    constrained_layout=True
)
fig.suptitle('choropleth map', fontsize=20)

# 入力データを描画
ax = axes[0]
gdf_target.boundary.plot(
    ax=ax,
    edgecolor='white', linewidth=0.5
) # 行政区界
gdf_target.plot(
    ax=ax, column='log_price',
    cmap='viridis', vmin=x_min, vmax=x_max,
    legend=True, legend_kwds={'label': 'logarithm price', 'shrink': 0.9}
) # 入力データ
ax.set_title(param_lbl, loc='left')

# 空間ラグを描画
ax = axes[1]
gdf_target.boundary.plot(
    ax=ax,
    edgecolor='white', linewidth=0.5
) # 行政区界
gdf_target.plot(
    ax=ax, column='spatial_lag',
    cmap='coolwarm', vmin=-v_size, vmax=v_size,
    legend=True, legend_kwds={'label': 'spatial lag', 'shrink': 0.9}
) # 空間ラグ

# 共通の装飾を追加
for ax in axes:
    for n in range(N):
        area_x, area_y = gdf_target.loc[n, 'centroids'].coords[0] # 座標
        area_lbl       = gdf_target.loc[n, 'city'] # 地域名
        ax.text(
            x=area_x, y=area_y,
            s=area_lbl, ha='center', va='center',
            size=10
        ) # 地域名
    ax.set_xlabel('longitude')
    ax.set_ylabel('latitude')
    ax.grid()
    ax.set_aspect(aspect='equal', adjustable='box')

plt.show()
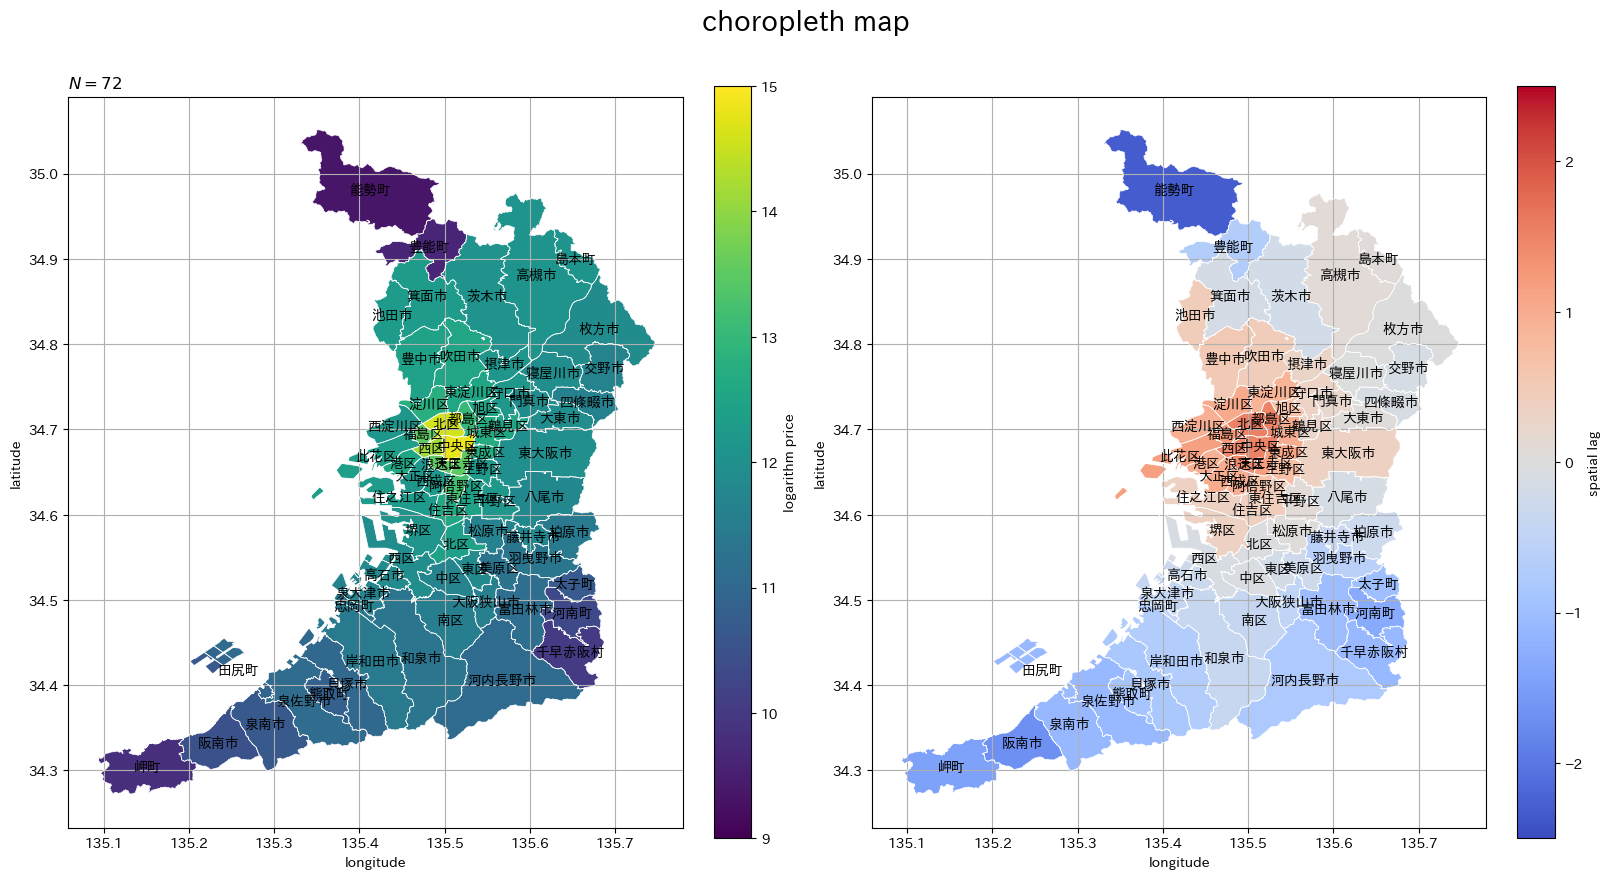
左図は入力データの値(平均対数地価公示価格)、右図は空間ラグの値をグラデーションで示します。偏差の図に関しては、0を中心とする範囲でグラデーション(値が0のとき灰色、値が小さいほど濃い青色、値が大きいほど濃い赤色)を設定しています。
散布図を作成します。
# 地域数を取得
N = len(gdf_target)

# 軸の範囲を設定
u = 1.5
x_min = x.min()
x_max = x.max()
x_min = np.floor(x_min /u)*u # u単位で切り上げ
x_max = np.ceil(x_max /u)*u  # u単位で切り上げ
u = 1.0
sl_size = np.abs(SL).max()
sl_size = np.ceil(sl_size /u)*u # u単位で切り上げ
# ラベルを作成
param_lbl = f'$N = {N}$'

# モラン散布図を作成
fig, ax = plt.subplots(
    figsize=(6, 6), dpi=100, facecolor='white',
    constrained_layout=True
)
fig.suptitle('scatterplot', fontsize=20)

ax.scatter(
    x=SL, y=x,
    s=50
) # 空間ラグ - 入力データ
'''
for n in range(N):
    ax.text(
        x=SL[n], y=x[n],
        s=gdf_target.loc[n, 'city'], ha='center', va='center'
    ) # 地域名
'''
ax.set_xlabel('$SL_i = \\sum_{j=1}^N w_{ij} (x_j - \\bar{x})$')
ax.set_ylabel('$x_i$')
ax.set_title(param_lbl, loc='left')
ax.grid()
ax.set_xlim(xmin=-sl_size, xmax=sl_size)
ax.set_ylim(ymin=x_min, ymax=x_max)

plt.show()
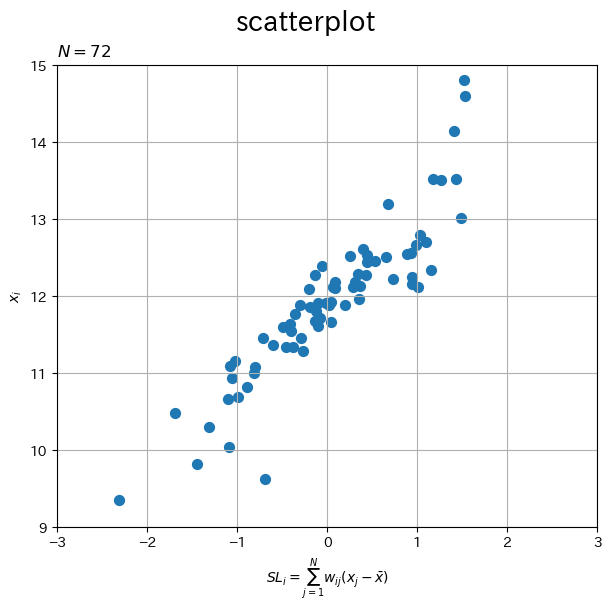
横軸を空間ラグ、縦軸を入力データの散布図で、データを示します。
結果の確認
カテゴリごとに色付けした散布図を作成します。
# カラーマップを指定
cmap = plt.get_cmap('tab10') # カラーマップを指定
# ラベルを作成
param_lbl = f'$N = {N}, K = {K}$'

# モラン散布図を作成
fig, ax = plt.subplots(
    figsize=(6, 6), dpi=100, facecolor='white',
    constrained_layout=True
)
fig.suptitle('scatterplot', fontsize=20)

for k in range(K):
    clust_lbl = f'$k = {k+1}, N_k = {clust_num[k]}$'
    ax.scatter(
        x=SL[c == k], y=x[c == k],
        color=cmap(k), s=50,
        label=clust_lbl
    ) # 空間ラグ - 入力データ

ax.set_xlabel('$SL_i = \\sum_{j=1}^N w_{ij} (x_j - \\bar{x})$')
ax.set_ylabel('$x_i$')
ax.set_title(param_lbl, loc='left')
ax.legend(title='cluster', loc='upper left')
ax.grid()
ax.set_xlim(xmin=-sl_size, xmax=sl_size)
ax.set_ylim(ymin=x_min, ymax=x_max)

plt.show()
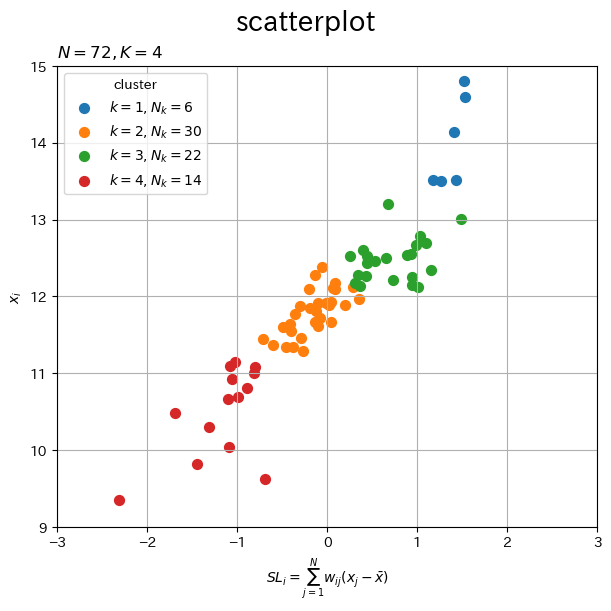
各地域に割り当てられたクラスタを色で示します。
ax.scatter() を使って、散布図を描画します。x座標の引数 x に空間ラグ、y座標の引数 y に入力データ、点の色の引数 color にカラーマップから出力した色データを指定します。
離散型のカラーマップは、ListedColormap() で作成できます。カテゴリカルマップ(以降の図)の配色と対応させる必要がなければ、カラーマップ名を指定するなどして作図できます。
クラスタのカテゴリカルマップを作成します。
# 値を格納
gdf_target['cluster'] = c + 1 # カテゴリ番号
# カラーマップを作成
clust_cmap = ListedColormap(
    [cmap(k) for k in range(K)]
)
# ラベルを作成
param_lbl = f'$N = {N}, K = {K}$'

# クラスタを作図
fig, ax = plt.subplots(
    figsize=(8, 9), dpi=100, facecolor='white',
    constrained_layout=True
)
fig.suptitle('cluster map', fontsize=20)

gdf_target.boundary.plot(
    ax=ax,
    edgecolor='white', linewidth=0.5
) # 行政区界
gdf_target.plot(
    ax=ax, column='cluster',
    cmap=clust_cmap, vmin=0, vmax=K, categorical=True,
    legend=True, legend_kwds={
        'title': 'cluster', 'loc': 'upper left'
    }
) # クラスタ

for n in range(N):
    area_x, area_y = gdf_target.loc[n, 'centroids'].coords[0] # 座標
    area_lbl       = gdf_target.loc[n, 'city'] # 地域名
    ax.text(
        x=area_x, y=area_y,
        s=area_lbl, ha='center', va='center',
        size=10
    ) # 地域名
ax.set_xlabel('longitude')
ax.set_ylabel('latitude')
ax.set_title(param_lbl, loc='left')
ax.grid()
ax.set_aspect(aspect='equal', adjustable='box')

plt.show()
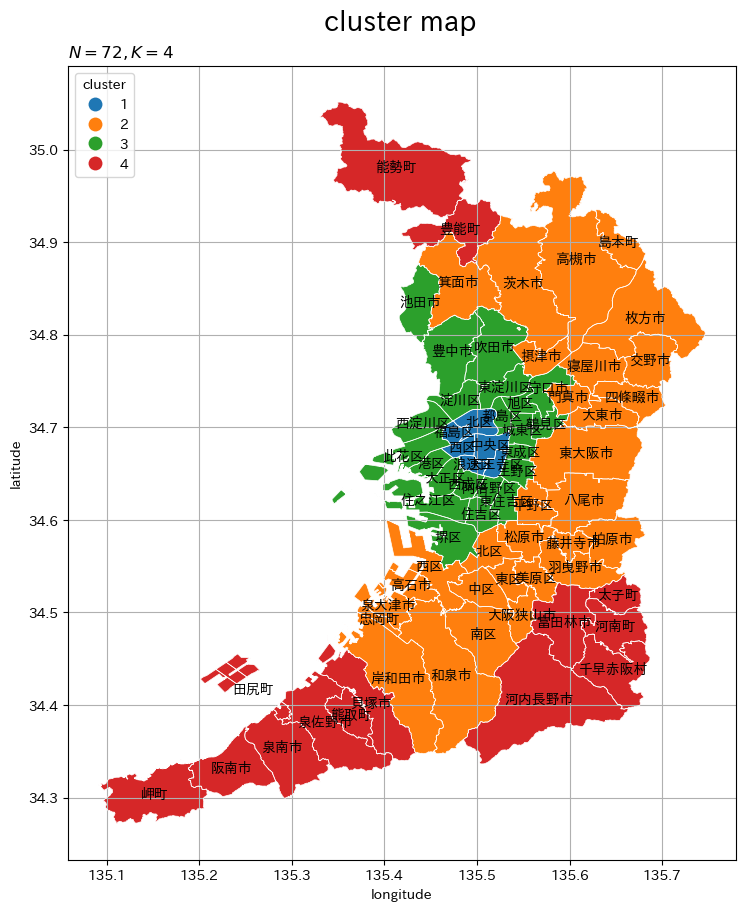
各地域に割り当てられたクラスタを塗りつぶしの色で示します。
GeoDataFrameと gdf.plot() を使って、カテゴリカル・コロプレス図を描画します。categorical 引数に True を指定すると離散型のデータ(カテゴリデータ)として扱われます。データ列の引数 column にクラスタ番号の列、カラーマップの引数 cmap に離散型のカラーマップを指定します。
カテゴリマップの凡例に装飾を追加します。
# カテゴリラベルを作成
clust_lbl_lt = [f'$k = {k+1}, N_k = {clust_num[k]}$' for k in range(K)]

# 値を格納
gdf_target['cluster_label'] = np.array(clust_lbl_lt)[c]

# カラーマップを作成
clust_cmap = ListedColormap(
    [cmap(k) for k in range(K)]
)

# カテゴリ順を設定
dtype = CategoricalDtype(
    categories=clust_lbl_lt,  ordered=True
)
gdf_target['cluster_label'] = gdf_target['cluster_label'].astype(dtype)
# ラベルを作成
param_lbl = f'$N = {N}, K = {K}$'

# クラスタを作図
fig, ax = plt.subplots(
    figsize=(8, 9), dpi=100, facecolor='white',
    constrained_layout=True
)
fig.suptitle('cluster map', fontsize=20)

gdf_target.boundary.plot(
    ax=ax,
    edgecolor='white', linewidth=0.5
) # 行政区界
gdf_target.plot(
    ax=ax, column='cluster_label',
    cmap=clust_cmap, categorical=True,
    legend=True, legend_kwds={
        'title': 'cluster', 'loc': 'upper left'
    }
) # クラスタ

for n in range(N):
    area_x, area_y = gdf_target.loc[n, 'centroids'].coords[0] # 座標
    area_lbl       = gdf_target.loc[n, 'city'] # 地域名
    ax.text(
        x=area_x, y=area_y,
        s=area_lbl, ha='center', va='center',
        size=10
    ) # 地域名
ax.set_xlabel('longitude')
ax.set_ylabel('latitude')
ax.set_title(param_lbl, loc='left')
ax.grid()
ax.set_aspect(aspect='equal', adjustable='box')

plt.show()
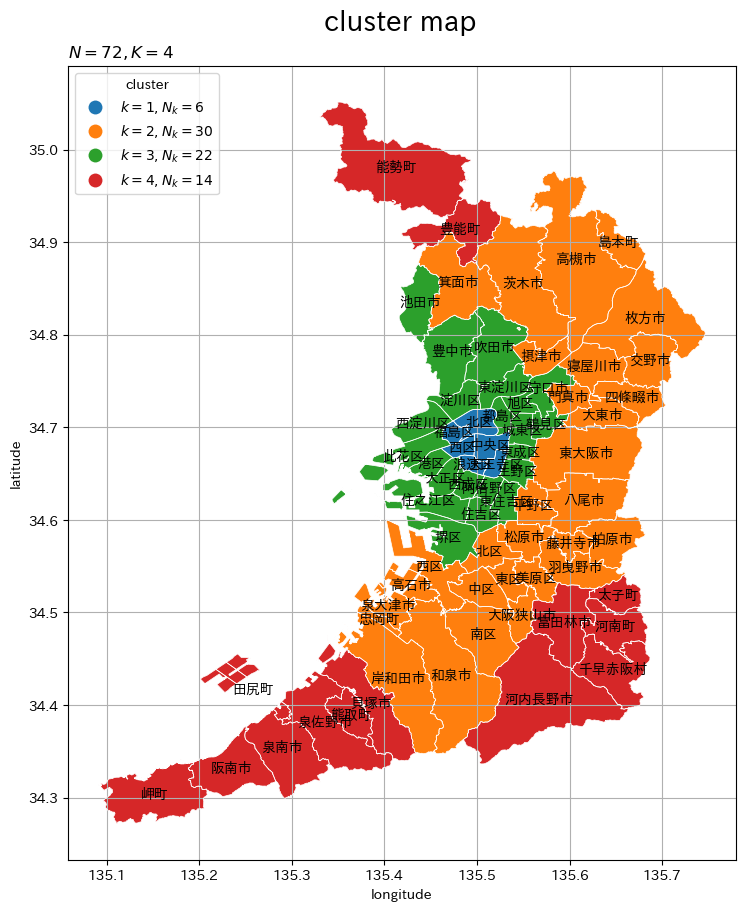
この例では、凡例に(クラスタ番号ではなく)クラスタラベル(クラスタごとの統計データなど)を表示するために、クラスタ番号に対応するようにクラスタラベルにPandasのCategorical型の順序を指定しています。Categorical型の順序は、CategoricalDtype() で設定できます。
または、辞書型のオブジェクトを使って配色を設定します。
# カテゴリラベルを作成
clust_lbl_lt = [f'$k = {k+1}, N_k = {clust_num[k]}$' for k in range(K)]

# 値を格納
gdf_target['cluster_label'] = np.array(clust_lbl_lt)[c]

# カラーマップを作成
colors = {clust_lbl_lt[k]: cmap(k) for k in range(K)}
# ラベルを作成
param_lbl = f'$N = {N}, K = {K}$'

# クラスタを作図
fig, ax = plt.subplots(
    figsize=(8, 9), dpi=100, facecolor='white',
    constrained_layout=True
)
fig.suptitle('cluster map', fontsize=20)

gdf_target.boundary.plot(
    ax=ax,
    edgecolor='white', linewidth=0.5
) # 行政区界
gdf_target.plot(
    ax=ax,
    color=gdf_target['cluster_label'].map(colors), categorical=True
) # クラスタ

for n in range(N):
    area_x, area_y = gdf_target.loc[n, 'centroids'].coords[0] # 座標
    area_lbl       = gdf_target.loc[n, 'city'] # 地域名
    ax.text(
        x=area_x, y=area_y,
        s=area_lbl, ha='center', va='center',
        size=10
    ) # 地域名
ax.set_xlabel('longitude')
ax.set_ylabel('latitude')
ax.set_title(param_lbl, loc='left')
ax.grid()
ax.set_aspect(aspect='equal', adjustable='box')

# 凡例を設定
handles = [
    mpatches.Patch(color=color, label=label) for label, color in colors.items()
]
ax.legend(
    handles=handles,
    title='cluster', loc='upper left'
)

plt.show()
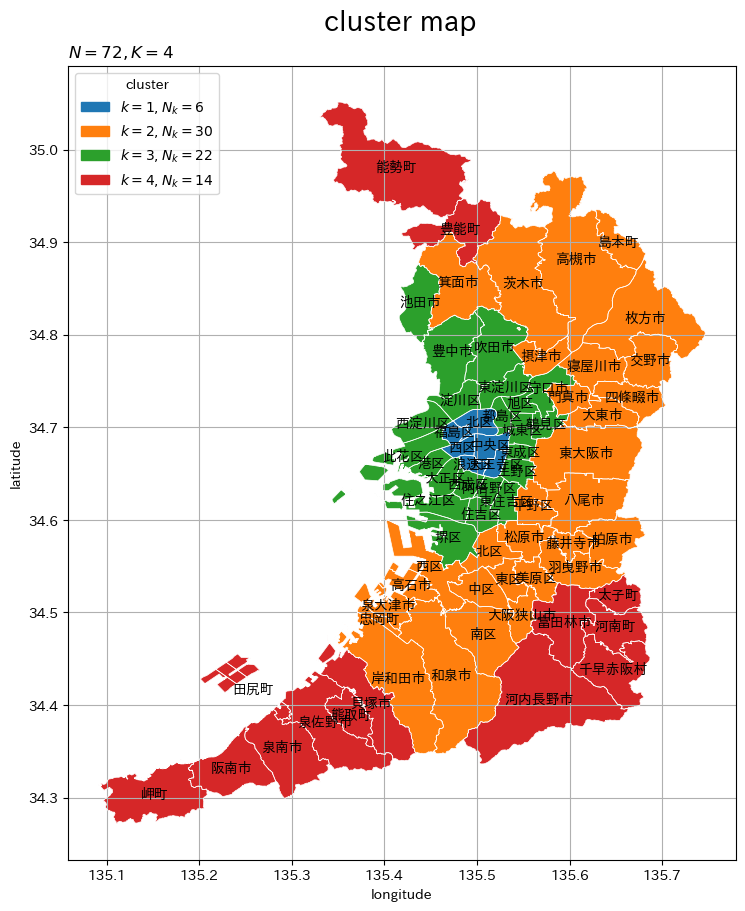
この例では、辞書型のオブジェクトとしてカラーマップを作成しています。カテゴリラベルをキー、色データを値として配色を指定します。
カテゴリラベル列の文字列をキーとして、辞書型のカラーマップから .map() で対応する色データを取り出して、塗りつぶし色の引数 color に色を指定します。
都市部や郊外でクラスタになっているのを確認できます。
以上で、クラスタの図を作成できました。
この記事では、k-means法によるクラスタリングを実装しました。次の記事では、k-means法を図で確認します。
参考文献

スポンサードリンク
おわりに
k-means法によるクラスタリングについては既に別の本の解説記事で書いたことがあるので(筆がノらず)飛ばしていましたが、GMIとLMIについて想定していた記事が書けたので、締めの応用例として取り組むことにしました。内容が重複するのでやらなくてもいいのですが、とは言えやらないのも気持ち悪いですしね。
geopandasで扱う地理空間データに対するクラスタリングと可視化という面で話を広げて差別化を図りました。既存記事の方は、追加機能なども実装していたり、3次元データの可視化を扱っていたり、アルゴリズムのより深い理解を目指す内容なので、k-means法に興味がおありであればそちらも合わせて読んでください。
既存記事の方は初稿ということもあり、読み返したら理解の薄さが気になったので並行して書き直しています、いつものように。
最後に、この記事の投稿日の前日に公開された私立恵比寿中学とマカロニえんぴつのはっとりさんのコラボ歌唱動画をどうぞ♪
【次の内容】
k平均法による空間ラグのクラスタリングを図で確認します。
https://www.anarchive-beta.com/entry/2026/08/14/180000www.anarchive-beta.com
